

Modelos de ChatGPT en 2026: qué hace cada uno y cuál te conviene
Qué modelos de ChatGPT conviene comparar
Elegir entre los modelos de ChatGPT exige distinguir qué capacidad necesitas, dónde vas a utilizarla y cuánto estás dispuesto a pagar. Además, los modelos disponibles en ChatGPT, ChatGPT Work, Codex y la API no siempre coinciden.
La llegada de GPT-6.1 Sol cambia la comparación con GPT-6 Astra y GPT-6 Luna. En esta guía repasamos sus diferencias, las tarifas de API y los criterios para elegir un modelo según tu tarea o proceso de negocio.
Qué modelos de ChatGPT conviene comparar
El catálogo actual de OpenAI destaca tres modelos de propósito general con enfoques distintos:
- GPT-6 Astra. Orientado al trabajo más exigente de razonamiento y programación.
- GPT-6.1 Sol. Busca equilibrar capacidad y coste en programación, uso del ordenador y trabajo profesional.
- GPT-6 Luna. Orientado a tareas acotadas y de gran volumen, en las que el coste por ejecución tiene especial importancia.
Las versiones anteriores pueden seguir siendo relevantes para determinadas configuraciones. Por eso, al comparar resultados o precios hay que identificar la versión completa: GPT-5.6 Sol, GPT-6 Sol y GPT-6.1 Sol no son intercambiables.
Qué cambia con GPT-6.1 Sol
OpenAI presenta GPT-6.1 Sol como un modelo con rendimiento cercano a Astra para trabajo complejo, pero con un coste inferior. Su documentación destaca la programación, el uso del ordenador y las tareas profesionales.
La diferencia económica es relevante. Sus tarifas base de API son de 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida, frente a los 10 y 50 dólares de Astra. Eso supone un precio por token un 80 % inferior, aunque el ahorro por tarea dependerá del consumo, las herramientas utilizadas y los reintentos.
Para una empresa, este cambio justifica volver a evaluar procesos en los que Astra ofrecía buenos resultados pero resultaba demasiado costoso. La decisión debe apoyarse en pruebas con documentos y tareas reales, midiendo también los errores y el tiempo de revisión.
Dónde puedes utilizar cada modelo
Conviene distinguir entre ChatGPT, ChatGPT Work, Codex y la API. Que un modelo esté disponible para integrar en una aplicación no significa que aparezca con el mismo nombre en todos los selectores de ChatGPT.
El anuncio de GPT-6.1 Sol contempla su uso en la API y Codex, sujeto a disponibilidad. En los entornos de trabajo también pueden intervenir el plan contratado, el despliegue y la configuración del administrador.
Antes de elegir, comprueba qué modelos puedes utilizar en tu entorno y qué condiciones se aplican. Los precios por token de esta comparativa corresponden a la API y no al precio mensual de una suscripción de ChatGPT.
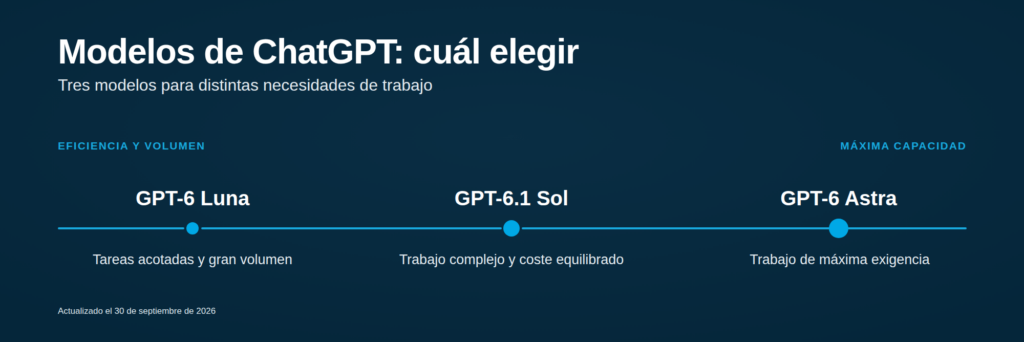
GPT-6 Luna, GPT-6.1 Sol y GPT-6 Astra: orientación para elegir según las necesidades de trabajo.
Cómo interpretar los benchmarks al comparar modelos
Los benchmarks permiten observar diferencias en tareas concretas, pero sus resultados dependen de la versión del modelo, el esfuerzo de razonamiento, las herramientas y las condiciones de ejecución. Una puntuación de una generación anterior no describe automáticamente a su sucesora.
Para decidir en una empresa, conviene complementar las pruebas publicadas con una evaluación propia. Utiliza ejemplos representativos del proceso, incluye excepciones y define de antemano qué resultado considerarás válido.
Compara la calidad de las respuestas, el tiempo de ejecución, el coste por tarea completada y la intervención humana necesaria. Un modelo más barato por token puede dejar de serlo si requiere más intentos o más correcciones.
Las limitaciones de los benchmarks
Los benchmarks ayudan a comparar modelos, pero sus resultados necesitan contexto. Antes de trasladarlos a una decisión de negocio, conviene revisar varios aspectos.
El esfuerzo de razonamiento influye: Una prueba ejecutada con una configuración exigente puede mejorar la puntuación, pero también aumentar el tiempo de respuesta y el consumo. Comprueba si esas condiciones se parecen a las que utilizarás.
Las herramientas y el entorno cambian el resultado: No es lo mismo evaluar un modelo por sí solo que permitirle buscar información, ejecutar código o revisar sus respuestas. El rendimiento publicado corresponde al conjunto de condiciones de la prueba.
La selección de pruebas ofrece una visión parcial: Cada evaluación mide determinadas capacidades. Revisa quién publica los resultados, qué metodología utiliza y qué tareas quedan fuera de la comparación.
La media puede ocultar el fallo que te importa: Una puntuación global alta no garantiza buenos resultados con tus documentos, tus datos o las excepciones de tu proceso. Además, los resultados corresponden a una versión concreta y no deben atribuirse automáticamente a otra.
La consistencia también cuenta: Además del porcentaje de aciertos, interesa comprobar si el modelo mantiene la calidad entre ejecuciones y cuánta revisión humana necesita. Una puntuación agregada puede no reflejar esa variabilidad.
La disponibilidad condiciona la elección: Verifica que el modelo y las funciones evaluadas estén disponibles en tu producto, plan y configuración. Una ventaja medida con herramientas a las que no tienes acceso puede no trasladarse a tu entorno.
Cuánto cuesta cada modelo en la API
Estas son las tarifas base de entrada y salida publicadas por OpenAI, consultadas el 30 de septiembre de 2026. Los importes están expresados en dólares por millón de tokens.
| Modelo | Entrada | Salida |
|---|---|---|
| GPT-6 Astra | 10 USD | 50 USD |
| GPT-6.1 Sol | 2 USD | 10 USD |
| GPT-6 Luna | 0,10 USD | 0,50 USD |
Estas cifras permiten una primera comparación, pero no equivalen al coste completo de una automatización. El presupuesto debe contemplar el consumo real, las herramientas y las condiciones de procesamiento aplicables.
Antes de calcular una previsión mensual, mide cuánto cuesta completar una tarea con una calidad aceptable y cuántas ejecuciones necesitarás.
Qué modelo conviene en cada caso
| Necesidad | Punto de partida para evaluar | Qué comprobar |
|---|---|---|
| Clasificación, extracción o resúmenes acotados a gran volumen | GPT-6 Luna | Precisión, excepciones y coste por tarea |
| Programación y trabajo profesional complejo | GPT-6.1 Sol | Calidad, tiempo y necesidad de correcciones |
| Tareas especialmente exigentes | Comparar GPT-6.1 Sol con GPT-6 Astra | Si la mejora obtenida compensa la diferencia de coste |
| Análisis de documentación extensa | Comparar con tus propios documentos | Recuperación de información, omisiones y fidelidad |
| Procesos con acciones sobre aplicaciones o sistemas | Evaluar el modelo dentro del flujo completo | Permisos, trazabilidad y puntos de validación humana |
Esta tabla propone por dónde empezar las pruebas. La elección final depende del proceso y del nivel de error que puedas aceptar.
Cómo eliges sin complicarte
Una regla sencilla ordena la decisión. Empieza por el modelo más barato que pueda resolver tu tarea y sube solo cuando falle de forma medible. Lo contrario, arrancar por el modelo frontera porque acaba de salir, multiplica la factura sin garantizar un resultado mejor en tu caso.
Para evaluar si un modelo cumple tus requisitos, prepara una muestra representativa de tareas reales, incluye las excepciones y define el criterio de aceptación antes de revisar los resultados. Esa prueba te permitirá comparar calidad, coste y necesidad de revisión humana en tu propio proceso.
Quién te ayuda a decidir
En LISDATA llevamos desde 2013 trabajando en ingeniería de datos, analítica avanzada e inteligencia artificial para empresas, con equipo en Vitoria, Cantabria y Hamburgo. Somos partner de Microsoft, trabajamos con Anthropic y contamos con certificación en gobierno del dato por DAMA International. Entendemos que una IA agéntica fiable empieza con unos datos preparados, gobernados y alineados con el negocio.
Montamos estas evaluaciones a menudo, y el patrón se repite. La elección de modelo raras veces es el cuello de botella, y sí lo son el estado de los datos, los permisos y el punto en el que una persona valida antes de que la acción tenga efecto.
Si estás decidiendo con qué modelo trabajar o quieres montar la prueba con tus propios casos, ¡cuéntanos el tuyo!
 Contactar